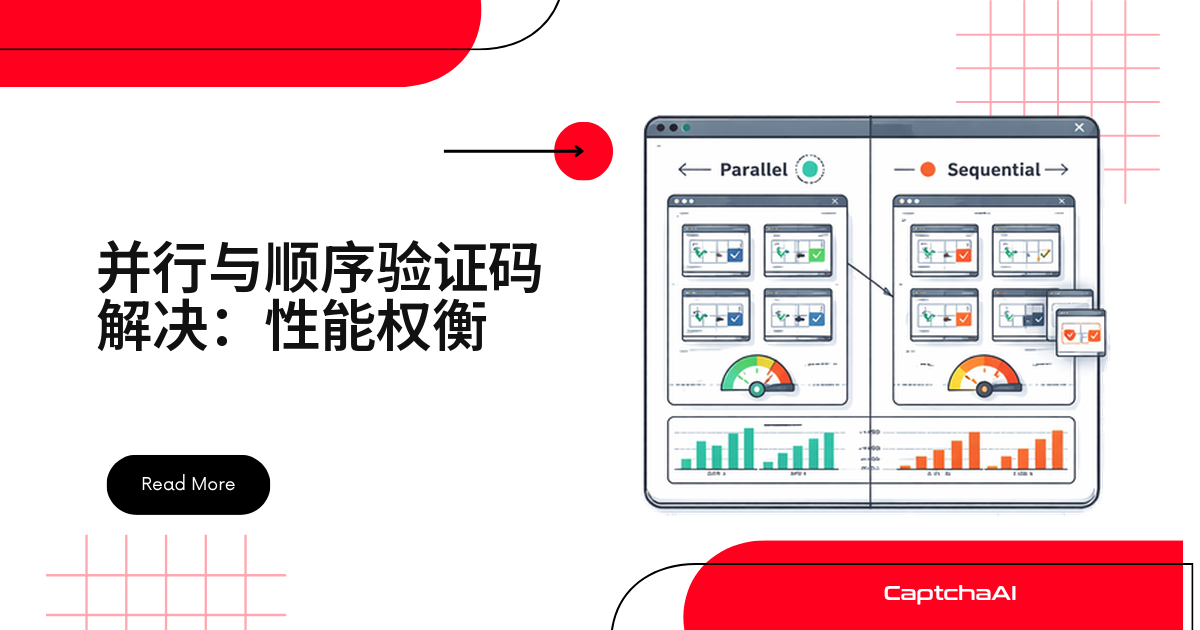
脚本每天处理多少次验证码?几十次顺序请求就够用;冲到日均数千次以上,顺序方案会先拖垮等待时间,这才是该上并行的临界点。本文用 CaptchaAI 的真实吞吐数据帮你判断怎么选。
先看决策卡
- < 500 次/天 — 顺序方案更简单
- 500–5,000 次/天 — 中等并发(10–25)就够
- > 5,000 次/天 — 50 并发起步
顺序求解:出错时一眼能看懂调用栈
一次只处理一个验证码:提交 → 等待 → 轮询 → 拿到 token → 下一个。
# sequential_solver.py
import os
import time
import requests

API_KEY = os.environ.get("CAPTCHAAI_KEY", "YOUR_API_KEY")

def solve_sequential(tasks):
    """Solve CAPTCHAs one by one."""
    results = []
    session = requests.Session()

    for task in tasks:
        # Submit
        resp = session.get("https://ocr.captchaai.com/in.php", params={
            "key": API_KEY,
            "method": "userrecaptcha",
            "googlekey": task["sitekey"],
            "pageurl": task["pageurl"],
            "json": "1",
        })
        result = resp.json()
        if result.get("status") != 1:
            results.append({"error": result.get("request")})
            continue

        task_id = result["request"]
        time.sleep(15)

        # Poll
        token = None
        for _ in range(25):
            poll = session.get("https://ocr.captchaai.com/res.php", params={
                "key": API_KEY, "action": "get",
                "id": task_id, "json": "1",
            })
            poll_result = poll.json()
            if poll_result.get("status") == 1:
                token = poll_result["request"]
                break
            if poll_result.get("request") != "CAPCHA_NOT_READY":
                break
            time.sleep(5)

        results.append({"token": token} if token else {"error": "timeout"})

    return results

# 10 tasks sequentially → ~150 seconds total
tasks = [{"sitekey": "SITEKEY", "pageurl": "https://example.com"}] * 10
start = time.time()
results = solve_sequential(tasks)
print(f"Completed in {time.time() - start:.0f}s")
单线程运行,出错时调用栈一目了然。适合:单页表单、本地调试、日请求 < 500 次、结果有先后依赖的场景。
并行求解:把吞吐量拉到 10,000+/小时
一次性提交所有验证码,统一等待结果:用信号量(Python)或连接池上限(JavaScript)控制并发数。
# parallel_solver.py
import os
import asyncio
import aiohttp

API_KEY = os.environ.get("CAPTCHAAI_KEY", "YOUR_API_KEY")

async def solve_one(session, sitekey, pageurl, semaphore):
    """Solve a single CAPTCHA within concurrency limits."""
    async with semaphore:
        # Submit
        async with session.get("https://ocr.captchaai.com/in.php", params={
            "key": API_KEY, "method": "userrecaptcha",
            "googlekey": sitekey, "pageurl": pageurl, "json": "1",
        }) as resp:
            result = await resp.json(content_type=None)

        if result.get("status") != 1:
            return {"error": result.get("request")}

        task_id = result["request"]
        await asyncio.sleep(15)

        # Poll
        for _ in range(25):
            async with session.get("https://ocr.captchaai.com/res.php", params={
                "key": API_KEY, "action": "get",
                "id": task_id, "json": "1",
            }) as resp:
                poll_result = await resp.json(content_type=None)

            if poll_result.get("status") == 1:
                return {"token": poll_result["request"]}
            if poll_result.get("request") != "CAPCHA_NOT_READY":
                return {"error": poll_result.get("request")}

            await asyncio.sleep(5)

        return {"error": "timeout"}

async def solve_parallel(tasks, max_concurrent=50):
    """Solve CAPTCHAs in parallel with concurrency control."""
    semaphore = asyncio.Semaphore(max_concurrent)
    connector = aiohttp.TCPConnector(limit=max_concurrent)

    async with aiohttp.ClientSession(connector=connector) as session:
        coros = [
            solve_one(session, t["sitekey"], t["pageurl"], semaphore)
            for t in tasks
        ]
        return await asyncio.gather(*coros)

# 10 tasks in parallel → ~20 seconds total
import time
tasks = [{"sitekey": "SITEKEY", "pageurl": "https://example.com"}] * 10
start = time.time()
results = asyncio.run(solve_parallel(tasks))
print(f"Completed in {time.time() - start:.0f}s")
JavaScript 版
// parallel_solver.js
const axios = require('axios');
const https = require('https');

const API_KEY = process.env.CAPTCHAAI_KEY || 'YOUR_API_KEY';
const agent = new https.Agent({ keepAlive: true, maxSockets: 50 });
const api = axios.create({ baseURL: 'https://ocr.captchaai.com', httpsAgent: agent });

async function solveOne(sitekey, pageurl) {
  const submit = await api.get('/in.php', {
    params: { key: API_KEY, method: 'userrecaptcha', googlekey: sitekey, pageurl, json: '1' },
  });
  if (submit.data.status !== 1) return { error: submit.data.request };

  await new Promise(r => setTimeout(r, 15000));

  for (let i = 0; i < 25; i++) {
    const poll = await api.get('/res.php', {
      params: { key: API_KEY, action: 'get', id: submit.data.request, json: '1' },
    });
    if (poll.data.status === 1) return { token: poll.data.request };
    if (poll.data.request !== 'CAPCHA_NOT_READY') return { error: poll.data.request };
    await new Promise(r => setTimeout(r, 5000));
  }
  return { error: 'timeout' };
}

(async () => {
  const tasks = Array.from({ length: 10 }, () => ({
    sitekey: 'SITEKEY', pageurl: 'https://example.com',
  }));

  const start = Date.now();
  const results = await Promise.all(tasks.map(t => solveOne(t.sitekey, t.pageurl)));
  console.log(`Completed in ${((Date.now() - start) / 1000).toFixed(0)}s`);
  console.log(`Solved: ${results.filter(r => r.token).length}/${tasks.length}`);

  agent.destroy();
})();
跨境电商团队批量测试海外表单时,页面常挂 reCAPTCHA v2,Google 脚本在国内网络下未必稳定加载,顺序请求会更慢;把 max_concurrent 设到套餐线程数,上面的并行代码即可直接复用。
顺序 vs 并行:核心指标一览
| 对比维度 | 顺序求解 | 并行求解 |
|---|---|---|
| 吞吐量(reCAPTCHA v2,15 秒中值) | 约 240 次/小时 | 10,000+ 次/小时 |
| 代码复杂度 | 简单 | 中等到复杂 |
| 错误处理 | 直接明了 | 需并发错误隔离 |
| 内存占用 | 最低(约 30 MB) | 随并发增长(约 100–500 MB) |
| 单次求解成本 | 相同 | 相同 |
| 调试难度 | 容易 | 更难(竞态、时序) |
| 顺序保证 | 天然保证 | 需索引跟踪 |
| 适合场景 | 每天 < 500 次 | 每天 > 500 次 |
并发数怎么选
| 并发数 | 吞吐量/小时 | 内存(Python) | 复杂度 |
|---|---|---|---|
| 1(顺序) | 240 | 30 MB | 低 |
| 10 | 2,400 | 50 MB | 低 |
| 25 | 6,000 | 80 MB | 中 |
| 50 | 10,000+ | 120 MB | 中 |
| 100 | 18,000+ | 200 MB | 高 |
以下数字基于公开资料与内部观测样本,仅供参考,实际结果请在自有环境中测量。
日处理 5,000 个页面,顺序需近 21 小时,50 并发半小时内可收尾;100 并发后收益递减。
混合方案:流程顺序执行,验证码并行求解
不必二选一:工作流程顺序处理,验证码求解单独摘出来并行跑,往往是最佳平衡点:
# Process 10 URLs sequentially, but solve their CAPTCHAs in a parallel batch
urls = get_next_batch()  # 10 URLs
captcha_params = [extract_sitekey(url) for url in urls]  # Sequential extraction
tokens = asyncio.run(solve_parallel(captcha_params, max_concurrent=10))  # Parallel solving
for url, result in zip(urls, tokens):
    submit_form(url, result.get("token"))  # Sequential submission
常见故障排查
- 并行速度低于预期 — 信号量设置过于保守,调大
max_concurrent - 偶发随机失败 — 协程/Promise 共享状态被污染,用独立状态变量
- 结果顺序看似乱了 —
asyncio.gather按输入顺序返回,先用索引对齐排查 ERROR_NO_SLOT_AVAILABLE— 并发提交短时间超限,提交间加几十毫秒间隔
常见问题
选 BASIC 套餐(5 线程)能跑并行方案吗?
能,但吞吐量有限。CaptchaAI 按线程数计费,BASIC($15/月,5 线程)、STANDARD($30/月,15 线程)、ADVANCE($90/月,50 线程)均可运行本文的并行代码,区别在于能同时挂多少个请求。
并行求解会不会更贵?
不会。CaptchaAI 按线程数计费,每个线程内解决次数不限,顺序和并行调用同一套 API、同样单价,并行只是更快跑完总量。
为什么会报 ERROR_NO_SLOT_AVAILABLE?
通常是并发请求短时间超过账号可用线程数。确认 max_concurrent 不超过套餐线程数即可。
下一步
先跑通顺序版本,遇到瓶颈再升级并行 —— 注册 CaptchaAI,拿到 API Key。
相关指南: