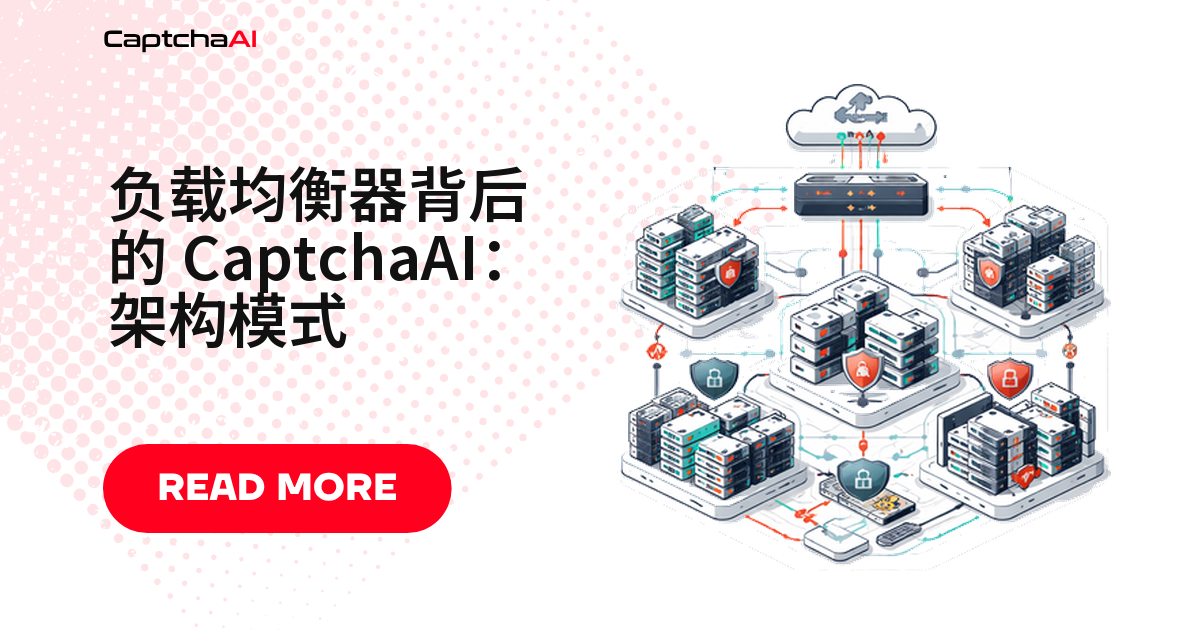
验证码识别请求量一大,单个 worker 很快顶到并发上限,开始排队甚至超时。这时候该做的不是拉长超时时间,而是在 worker 前面加一层负载均衡:分散请求、提升吞吐量、故障自动切换,还能按需水平扩容。
架构总览
整体思路很简单:抓取端把请求打到负载均衡器,再分发给后面的多个 worker,各自调用 CaptchaAI API。
[Scraper 1] ──┐                      ┌── [Worker 1] ──→ CaptchaAI API
[Scraper 2] ──┤── [Load Balancer] ──┤── [Worker 2] ──→ CaptchaAI API
[Scraper 3] ──┘                      └── [Worker 3] ──→ CaptchaAI API
路由策略怎么选
动手配置前先定策略,这决定了 NGINX upstream 块怎么写。
| 策略 | 工作原理 | 适用场景 |
|---|---|---|
| 轮询 | 按顺序依次分配 | worker 能力相近 |
| 最少连接 | 分配给当前连接数最少的 worker | 验证码识别(任务耗时不固定) |
| 加权 | 按权重比例分配 | worker 能力不均衡 |
| IP 哈希 | 同一客户端固定分配同一 worker | 需要会话保持 |
| 随机 | 随机选择 worker | 简单场景,负载分布均匀 |
建议: 验证码识别任务优先用最少连接——任务耗时从几秒到一两分钟不等,轮询容易让某个 worker 堆积长任务。
算法选择速查
- worker 能力接近、耗时波动小时,轮询就够用。
- 耗时波动大时优先用最少连接,否则长任务会堆积在同一个 worker 上。
- 备用 worker、IP 哈希只在需要故障隔离或会话敏感场景才启用,不要默认打开。
用 NGINX 做负载均衡
生产环境最常见的做法是用 NGINX 做七层负载均衡。
轮询(默认策略)
upstream captcha_workers {
    server 10.0.1.10:8080;
    server 10.0.1.11:8080;
    server 10.0.1.12:8080;
}

server {
    listen 80;
    server_name captcha.internal;

    location /solve {
        proxy_pass http://captcha_workers;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_connect_timeout 10s;
        proxy_read_timeout 300s;  # CAPTCHA solving can take minutes
    }

    location /health {
        proxy_pass http://captcha_workers;
        proxy_connect_timeout 5s;
        proxy_read_timeout 5s;
    }
}
最少连接(更适合验证码识别负载)
upstream captcha_workers {
    least_conn;  # Route to worker with fewest active connections
    server 10.0.1.10:8080;
    server 10.0.1.11:8080;
    server 10.0.1.12:8080 weight=2;  # Higher capacity worker

    # Health checks
    server 10.0.1.10:8080 max_fails=3 fail_timeout=30s;
    server 10.0.1.11:8080 max_fails=3 fail_timeout=30s;
    server 10.0.1.12:8080 max_fails=3 fail_timeout=30s;
}
配置备用 worker
upstream captcha_workers {
    least_conn;
    server 10.0.1.10:8080;
    server 10.0.1.11:8080;
    server 10.0.1.12:8080 backup;  # Only used when others are down
}
Worker 端 API 服务
负载均衡器只管转发,真正处理识别任务的是后面的 worker。下面是一个包含限流和健康检查的最小实现。
Python(Flask)实现
import os
import time
import threading
import requests
from flask import Flask, request, jsonify

API_KEY = os.environ["CAPTCHAAI_API_KEY"]
app = Flask(__name__)

# Track active tasks for load reporting
active_tasks = 0
tasks_lock = threading.Lock()
max_concurrent = int(os.environ.get("MAX_CONCURRENT", "20"))


@app.route("/solve", methods=["POST"])
def solve():
    global active_tasks
    with tasks_lock:
        if active_tasks >= max_concurrent:
            return jsonify({"error": "WORKER_AT_CAPACITY"}), 503
        active_tasks += 1

    try:
        data = request.json
        result = solve_captcha(data)
        return jsonify(result)
    finally:
        with tasks_lock:
            active_tasks -= 1


@app.route("/health")
def health():
    with tasks_lock:
        load = active_tasks / max_concurrent
    return jsonify({
        "status": "healthy" if load < 0.9 else "overloaded",
        "active_tasks": active_tasks,
        "max_concurrent": max_concurrent,
        "load_pct": round(load * 100, 1)
    }), 200 if load < 0.9 else 503


def solve_captcha(data):
    session = requests.Session()
    payload = {
        "key": API_KEY,
        "method": data.get("method", "userrecaptcha"),
        "googlekey": data.get("sitekey"),
        "pageurl": data.get("pageurl"),
        "json": 1
    }

    if data.get("proxy"):
        payload["proxy"] = data["proxy"]
        payload["proxytype"] = data.get("proxytype", "HTTP")

    resp = session.post("https://ocr.captchaai.com/in.php", data=payload)
    result = resp.json()
    if result.get("status") != 1:
        return {"error": result.get("request")}

    captcha_id = result["request"]
    for _ in range(60):
        time.sleep(5)
        poll = session.get("https://ocr.captchaai.com/res.php", params={
            "key": API_KEY, "action": "get", "id": captcha_id, "json": 1
        }).json()
        if poll.get("status") == 1:
            return {"solution": poll["request"], "captcha_id": captcha_id}
        if poll.get("request") != "CAPCHA_NOT_READY":
            return {"error": poll.get("request")}

    return {"error": "TIMEOUT"}


if __name__ == "__main__":
    app.run(host="0.0.0.0", port=8080, threaded=True)
JavaScript(Express)实现
const express = require("express");
const axios = require("axios");

const API_KEY = process.env.CAPTCHAAI_API_KEY;
const MAX_CONCURRENT = parseInt(process.env.MAX_CONCURRENT || "20", 10);
const PORT = parseInt(process.env.PORT || "8080", 10);

let activeTasks = 0;
const app = express();
app.use(express.json());

app.post("/solve", async (req, res) => {
  if (activeTasks >= MAX_CONCURRENT) {
    return res.status(503).json({ error: "WORKER_AT_CAPACITY" });
  }
  activeTasks++;

  try {
    const result = await solveCaptcha(req.body);
    res.json(result);
  } catch (err) {
    res.status(500).json({ error: err.message });
  } finally {
    activeTasks--;
  }
});

app.get("/health", (req, res) => {
  const load = activeTasks / MAX_CONCURRENT;
  const status = load < 0.9 ? "healthy" : "overloaded";
  res
    .status(load < 0.9 ? 200 : 503)
    .json({ status, activeTasks, maxConcurrent: MAX_CONCURRENT, loadPct: Math.round(load * 100) });
});

async function solveCaptcha(data) {
  const submitResp = await axios.post("https://ocr.captchaai.com/in.php", null, {
    params: {
      key: API_KEY,
      method: data.method || "userrecaptcha",
      googlekey: data.sitekey,
      pageurl: data.pageurl,
      json: 1,
    },
  });

  if (submitResp.data.status !== 1) {
    return { error: submitResp.data.request };
  }

  const captchaId = submitResp.data.request;
  for (let i = 0; i < 60; i++) {
    await new Promise((r) => setTimeout(r, 5000));
    const pollResp = await axios.get("https://ocr.captchaai.com/res.php", {
      params: { key: API_KEY, action: "get", id: captchaId, json: 1 },
    });

    if (pollResp.data.status === 1) {
      return { solution: pollResp.data.request, captchaId };
    }
    if (pollResp.data.request !== "CAPCHA_NOT_READY") {
      return { error: pollResp.data.request };
    }
  }
  return { error: "TIMEOUT" };
}

app.listen(PORT, () => console.log(`Worker listening on port ${PORT}`));
没有负载均衡器?客户端也能做路由
没条件部署独立负载均衡器时,可在客户端里做路由:记录每个 worker 活跃任务数,请求失败或返回 503 时标记不健康并重试下一个。
import random
import requests

class ClientLoadBalancer:
    def __init__(self, workers):
        self.workers = [
            {"url": url, "healthy": True, "active": 0}
            for url in workers
        ]

    def get_worker(self):
        healthy = [w for w in self.workers if w["healthy"]]
        if not healthy:
            raise Exception("No healthy workers")
        return min(healthy, key=lambda w: w["active"])

    def solve(self, task):
        worker = self.get_worker()
        worker["active"] += 1
        try:
            resp = requests.post(
                f"{worker['url']}/solve",
                json=task,
                timeout=300
            )
            if resp.status_code == 503:
                worker["healthy"] = False
                return self.solve(task)  # Retry on another worker
            return resp.json()
        except requests.RequestException:
            worker["healthy"] = False
            return self.solve(task)
        finally:
            worker["active"] -= 1


lb = ClientLoadBalancer([
    "http://10.0.1.10:8080",
    "http://10.0.1.11:8080",
    "http://10.0.1.12:8080"
])
result = lb.solve({"sitekey": "6Le-wvkS...", "pageurl": "https://example.com"})
故障排查
| 问题 | 原因 | 处理方式 |
|---|---|---|
| 502 网关错误 | worker 崩溃或未启动 | 检查 worker 日志,确认端口绑定正常 |
| 负载分布不均 | 任务耗时不固定却用了轮询 | 切换为最少连接 |
| 健康检查误报 | 检查通过但 worker 已满负荷 | 响应里带上负载百分比 |
| 连接超时 | proxy_read_timeout 设置过短 |
调整为 300 秒以上,匹配验证码识别的实际耗时 |
相关文章
下一步
把验证码识别吞吐量扩展起来——获取 CaptchaAI API 密钥,部署到负载均衡器后面。
相关指南:
常见问题
国内的负载均衡产品能用来分发 CaptchaAI 请求吗?
阿里云 SLB、腾讯云 CLB 都能直接用,转发到 worker 的 HTTP 接口即可。worker 部署在海外时,健康检查和转发超时要按识别耗时设置。
小规模部署(2-3 个 worker)有必要上专用负载均衡器吗?
不一定。客户端负载均衡足够应付小规模场景;超过 5 个 worker,或需要 SSL 终止等功能时,再换成 NGINX、HAProxy 也不迟。
worker 数量该怎么估算?
先看 CaptchaAI 套餐线程数——比如 ADVANCE 套餐 $90/月、50 线程。worker 的 MAX_CONCURRENT 建议略低于套餐线程数,留出余量即可。
健康检查只测端口通不通够吗?
不够。端口通只说明进程还活着,测不出是否已满载。让 /health 返回活跃任务数和负载百分比,才能在满载前把新请求导流走。