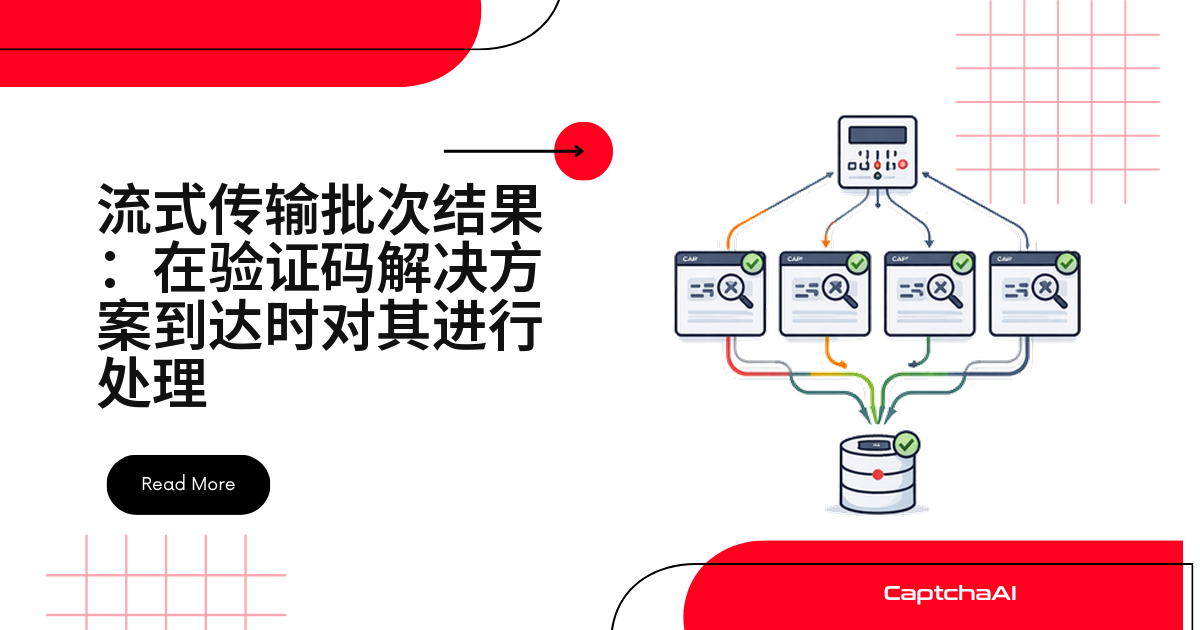
批量提交 500 个验证码任务后,收尾动作不该是 await asyncio.gather(*tasks) 等一个总结果,而是让每条 token 到手就流向下游。同一批任务耗时不齐:Turnstile 上限 <10 秒,reCAPTCHA v2 上限 <60 秒——等最慢的那条,先完成的几百条 token 只能空耗有效期。
先算一笔账:三种消费方式的取舍
| 方案 | 首条可用时间 | 内存 | 下游延迟 |
|---|---|---|---|
| 等全部完成 | 最慢任务返回后 | 全部驻留 | 高 |
| 边识别边产出 | 最快任务返回后 | 只持有一条 | 低 |
| 微批(10 条) | 第一组凑齐后 | 持有 10 条 | 中 |
这批任务到底该不该流式处理
| 场景 | 建议做法 |
|---|---|
| 拿到 token 就提交表单 | 流式 |
| 全量结果导出成 CSV | 收齐再写 |
| 任务之间有先后依赖 | 收齐按序处理 |
| 单批 1,000 条以上 | 流式,压住内存峰值 |
Python:用异步生成器边识别边产出
asyncio 加 aiohttp 最自然:谁先识别完谁先被 yield 出来,调用方一个 async for 就能消费;Semaphore 控住在途任务数,asyncio.wait(..., return_when=FIRST_COMPLETED) 负责唤醒完成的那条:
import asyncio
import aiohttp
import time

API_KEY = "YOUR_API_KEY"
SUBMIT_URL = "https://ocr.captchaai.com/in.php"
RESULT_URL = "https://ocr.captchaai.com/res.php"


async def submit_task(session, task_data):
    """Submit a single CAPTCHA task."""
    params = {
        "key": API_KEY,
        "method": task_data.get("method", "userrecaptcha"),
        "json": 1,
    }
    if params["method"] == "userrecaptcha":
        params["googlekey"] = task_data["sitekey"]
        params["pageurl"] = task_data["pageurl"]
    elif params["method"] == "turnstile":
        params["sitekey"] = task_data["sitekey"]
        params["pageurl"] = task_data["pageurl"]

    async with session.post(SUBMIT_URL, data=params) as resp:
        result = await resp.json(content_type=None)
        if result.get("status") != 1:
            return None, result.get("request", "unknown")
        return result["request"], None


async def poll_task(session, task_id, timeout=300):
    """Poll until solved or timeout."""
    start = time.monotonic()
    while time.monotonic() - start < timeout:
        await asyncio.sleep(5)
        params = {"key": API_KEY, "action": "get", "id": task_id, "json": 1}
        async with session.get(RESULT_URL, params=params) as resp:
            result = await resp.json(content_type=None)

        if result.get("request") == "CAPCHA_NOT_READY":
            continue
        if result.get("status") == 1:
            return result["request"], None
        return None, result.get("request", "unknown")

    return None, "TIMEOUT"


async def solve_one(session, index, task_data, semaphore):
    """Solve a single task within concurrency limits."""
    async with semaphore:
        start = time.monotonic()
        task_id, error = await submit_task(session, task_data)
        if error:
            return {"index": index, "status": "failed", "error": error, "time": 0}

        token, error = await poll_task(session, task_id)
        elapsed = time.monotonic() - start

        if token:
            return {"index": index, "status": "solved", "token": token, "time": round(elapsed, 1)}
        return {"index": index, "status": "failed", "error": error, "time": round(elapsed, 1)}


async def stream_results(tasks, max_concurrent=20):
    """
    Async generator that yields each result as it completes.
    Results arrive in completion order, not submission order.
    """
    semaphore = asyncio.Semaphore(max_concurrent)

    async with aiohttp.ClientSession() as session:
        pending = set()
        for i, task in enumerate(tasks):
            coro = solve_one(session, i, task, semaphore)
            pending.add(asyncio.ensure_future(coro))

        while pending:
            done, pending = await asyncio.wait(pending, return_when=asyncio.FIRST_COMPLETED)
            for future in done:
                yield future.result()


async def main():
    tasks = [
        {"sitekey": "SITE_KEY", "pageurl": f"https://example.com/page{i}"}
        for i in range(50)
    ]

    solved = 0
    failed = 0

    async for result in stream_results(tasks, max_concurrent=15):
        # Process each result immediately
        if result["status"] == "solved":
            solved += 1
            print(f"  [{solved + failed}/{len(tasks)}] Task {result['index']} SOLVED in {result['time']}s")

            # Use token immediately — don't wait for batch
            # await submit_form(result["token"])
            # await save_to_database(result)
        else:
            failed += 1
            print(f"  [{solved + failed}/{len(tasks)}] Task {result['index']} FAILED: {result['error']}")

    print(f"\nDone: {solved} solved, {failed} failed")


asyncio.run(main())
两个细节:
- 结果按完成顺序到达,还原顺序靠每条自带的
index。 timeout=300不能省,否则pending清不空,生成器会挂死。
安装依赖:
pip install aiohttp
国内可加 -i https://pypi.tuna.tsinghua.edu.cn/simple 走镜像。
Node.js:用 EventEmitter 把结果广播给下游
事件模型本身就是流:CaptchaStream 继承 EventEmitter,识别完一条就 emit("result"),全部结束再 emit("done"):
const { EventEmitter } = require("events");

const API_KEY = "YOUR_API_KEY";
const SUBMIT_URL = "https://ocr.captchaai.com/in.php";
const RESULT_URL = "https://ocr.captchaai.com/res.php";

class CaptchaStream extends EventEmitter {
  constructor(maxConcurrent = 15) {
    super();
    this.maxConcurrent = maxConcurrent;
    this.active = 0;
    this.queue = [];
    this.total = 0;
    this.completed = 0;
  }

  async submitAndPoll(index, taskData) {
    const params = new URLSearchParams({
      key: API_KEY,
      method: taskData.method || "userrecaptcha",
      googlekey: taskData.sitekey,
      pageurl: taskData.pageurl,
      json: "1",
    });

    const start = Date.now();
    const submitResp = await (await fetch(SUBMIT_URL, { method: "POST", body: params })).json();

    if (submitResp.status !== 1) {
      return { index, status: "failed", error: submitResp.request, time: 0 };
    }

    const taskId = submitResp.request;
    for (let i = 0; i < 60; i++) {
      await new Promise((r) => setTimeout(r, 5000));
      const url = `${RESULT_URL}?key=${API_KEY}&action=get&id=${taskId}&json=1`;
      const poll = await (await fetch(url)).json();

      if (poll.request === "CAPCHA_NOT_READY") continue;
      const elapsed = ((Date.now() - start) / 1000).toFixed(1);
      if (poll.status === 1) return { index, status: "solved", token: poll.request, time: elapsed };
      return { index, status: "failed", error: poll.request, time: elapsed };
    }
    return { index, status: "failed", error: "TIMEOUT", time: ((Date.now() - start) / 1000).toFixed(1) };
  }

  async processNext() {
    if (this.queue.length === 0 || this.active >= this.maxConcurrent) return;

    const { index, taskData } = this.queue.shift();
    this.active++;

    try {
      const result = await this.submitAndPoll(index, taskData);
      this.emit("result", result);
    } catch (err) {
      this.emit("result", { index, status: "failed", error: err.message });
    } finally {
      this.active--;
      this.completed++;

      if (this.completed === this.total) {
        this.emit("done");
      } else {
        this.processNext();
      }
    }
  }

  start(tasks) {
    this.total = tasks.length;
    this.queue = tasks.map((taskData, index) => ({ index, taskData }));

    // Launch initial batch
    const initial = Math.min(this.maxConcurrent, tasks.length);
    for (let i = 0; i < initial; i++) {
      this.processNext();
    }
    return this;
  }
}

// Usage
const tasks = Array.from({ length: 50 }, (_, i) => ({
  sitekey: "SITE_KEY",
  pageurl: `https://example.com/page${i}`,
}));

const stream = new CaptchaStream(15);
let solved = 0, failed = 0;

stream.on("result", (result) => {
  if (result.status === "solved") {
    solved++;
    console.log(`[${solved + failed}/${tasks.length}] Task ${result.index} SOLVED (${result.time}s)`);
    // Use token immediately
    // submitForm(result.token);
  } else {
    failed++;
    console.log(`[${solved + failed}/${tasks.length}] Task ${result.index} FAILED: ${result.error}`);
  }
});

stream.on("done", () => {
  console.log(`\nComplete: ${solved} solved, ${failed} failed`);
});

stream.start(tasks);
监听器里只做轻量动作,写库、提交表单再丢一层队列——慢监听器会拖住整条回调链。
并发数怎么定:线程数就是流的宽度
max_concurrent 应当等于套餐线程数,套餐内识别次数不限:
- BASIC($15/月)5 线程
- STANDARD($30/月)15 线程,即示例里的值
- ADVANCE($90/月)50 线程
设高了只是在服务端排队,首条反而更晚。吞吐还取决于类型:Turnstile 上限 <10 秒,15 线程一分钟至少过 90 条;reCAPTCHA v2 上限 <60 秒,保底约 15 条。国内站点更多是 GeeTest(极验)滑块,同一套框架通用,区别只在 method——CaptchaAI 支持 GeeTest v3。
以上是按 SLA 上限推算的保守下限,请在自有或已授权的环境实测。
失败与续跑
- 失败也是一条结果:异常被收敛成
status: "failed"事件下发,流不会提前退出。 - 重试分档:
ERROR_ZERO_BALANCE这类账号级错误直接中止告警;TIMEOUT等这轮跑完,再按指数退避重投。 - 断点续跑:每产出一条就往 checkpoint 追加
index与状态,不要落盘 token。
常见故障与排查
- 顺序对不上:正常,用
result.index映射回原任务。 - 内存一直涨:结果被 append 进了数组,改成用完即弃。
- 首条迟迟不来:任务同时挤进去了,用信号量错开提交。
- 报 MaxListenersExceeded:监听器太多,每种事件只留一个。
- 进程挂住不返回:
pending里有不结束的任务,给poll_task加超时。
常见问题
并发到底开到多少合适?
上限就是套餐线程数:BASIC 5、STANDARD 15、ADVANCE 50,max_concurrent 设成同一个值。如果你同时也在向自己的页面发请求,瓶颈往往在那一侧。
token 可以先攒着,最后统一提交吗?
不建议。识别结果是一次性凭据,有效期很短,攒一批再提交最容易“拿到时还有效、用到时已过期”。
某一条任务失败,会中断整个流吗?
不会,前提是把失败也当成一条结果产出:示例在 solve_one 和 processNext 里都捕获了异常。会挂死的是没有超时的轮询。
相关文章
同类主题:用 Kafka 承接流式识别结果、按优先级排队的批量识别。
下一步
别让 token 在内存里干等——领取你的 CaptchaAI API Key,把异步生成器接进管道,先跑 50 条看看效果。
延伸阅读:CSV 驱动的批量识别、队列化批量处理、并行识别的并发模型。