单进程串行识别验证码,吞吐上限就是"一次一个"。把任务放进 Redis 队列、再用多个 worker 并发消费,是最省事的横向扩展方案:一个 List 当 FIFO 队列,一个 Hash 存结果,一个 Pub/Sub 频道做完成通知,三个原语就够。
下面这套 Python 实现可以直接跑。开始前准备好 Redis 实例、Python 3.8+(装好 redis 与 requests,国内可走清华镜像)和一个放在 CAPTCHAAI_KEY 里的 API Key。
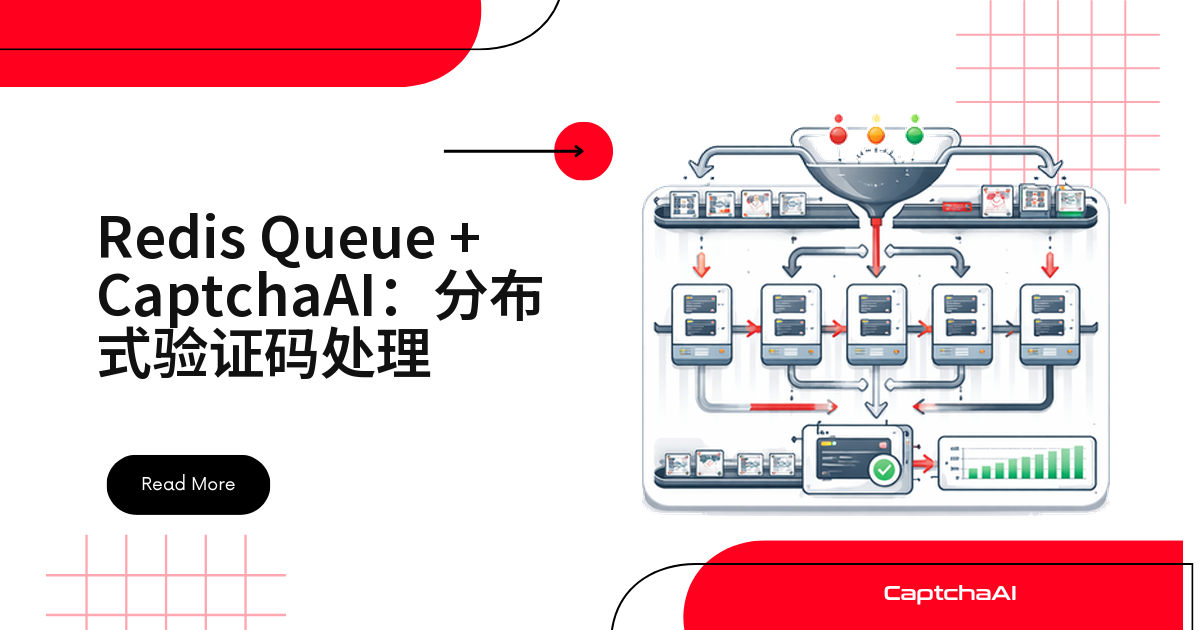
整体架构:队列、结果、通知三条链路
Producers → Redis List (FIFO queue) → Workers → CaptchaAI API
                                          ↓
                                   Redis Hash (results)
                                          ↓
                                   Redis Pub/Sub (notifications)
List 派活,同一任务只会被一个 worker 取走;Hash 存结果,任意进程按 task ID 就能查;Pub/Sub 把完成事件实时推出去,省掉高频轮询。
任务队列管理器:入队、取任务、存结果
import json
import time
import uuid
import redis


class CaptchaQueue:
    """Redis-backed CAPTCHA task queue."""

    def __init__(self, redis_url="redis://localhost:6379"):
        self.redis = redis.from_url(redis_url)
        self.queue_key = "captcha:tasks"
        self.results_key = "captcha:results"
        self.notify_channel = "captcha:done"

    def submit(self, method, params, priority="normal"):
        """Submit a CAPTCHA task to the queue."""
        task_id = str(uuid.uuid4())[:8]
        task = {
            "id": task_id,
            "method": method,
            "params": params,
            "submitted_at": time.time(),
            "priority": priority,
        }

        if priority == "high":
            self.redis.lpush(self.queue_key, json.dumps(task))
        else:
            self.redis.rpush(self.queue_key, json.dumps(task))

        return task_id

    def fetch(self, timeout=30):
        """Fetch next task from queue (blocking)."""
        result = self.redis.blpop(self.queue_key, timeout=timeout)
        if result is None:
            return None
        _, raw = result
        return json.loads(raw)

    def store_result(self, task_id, result):
        """Store task result and notify listeners."""
        self.redis.hset(
            self.results_key,
            task_id,
            json.dumps(result),
        )
        # Notify via pub/sub
        self.redis.publish(self.notify_channel, task_id)
        # Set TTL on result (1 hour)
        # Results are in a hash, so we track expiry separately
        self.redis.setex(
            f"captcha:ttl:{task_id}", 3600, "1",
        )

    def get_result(self, task_id):
        """Get result for a task (non-blocking)."""
        raw = self.redis.hget(self.results_key, task_id)
        if raw:
            return json.loads(raw)
        return None

    def wait_result(self, task_id, timeout=120):
        """Wait for a task result via polling."""
        start = time.time()
        while time.time() - start < timeout:
            result = self.get_result(task_id)
            if result:
                return result
            time.sleep(1)
        return None

    def queue_stats(self):
        """Get queue statistics."""
        return {
            "pending": self.redis.llen(self.queue_key),
            "completed": self.redis.hlen(self.results_key),
        }
三个要点:高优任务 lpush 插队头,普通任务 rpush 排队尾;取任务用阻塞式 blpop,worker 空闲时不空转 CPU;Hash 字段不能单独过期,所以另用一个键做 1 小时标记。
worker 进程:从队列取任务并调用 CaptchaAI
worker 是唯一和 CaptchaAI 打交道的角色:in.php 提交任务拿到 captcha ID,res.php 每 5 秒轮询一次,拿到 token 写回 Redis。失败和超时都写成结构化结果,不让进程崩掉。
import os
import time
import requests


class QueueWorker:
    """Worker that processes CAPTCHA tasks from Redis queue."""

    def __init__(self, api_key, queue):
        self.api_key = api_key
        self.queue = queue
        self.base = "https://ocr.captchaai.com"

    def run(self):
        """Main worker loop."""
        worker_id = os.getpid()
        print(f"Worker {worker_id} started")

        while True:
            task = self.queue.fetch(timeout=30)
            if task is None:
                continue

            task_id = task["id"]
            print(f"[{worker_id}] Processing {task_id}")

            start = time.time()
            try:
                token = self._solve(task["method"], task["params"])
                duration = time.time() - start
                self.queue.store_result(task_id, {
                    "status": "success",
                    "token": token,
                    "duration": f"{duration:.1f}s",
                })
                print(f"[{worker_id}] {task_id} solved in {duration:.1f}s")

            except Exception as e:
                self.queue.store_result(task_id, {
                    "status": "error",
                    "error": str(e),
                })
                print(f"[{worker_id}] {task_id} failed: {e}")

    def _solve(self, method, params, timeout=120):
        resp = requests.post(f"{self.base}/in.php", data={
            "key": self.api_key,
            "method": method,
            "json": 1,
            **params,
        }, timeout=30)
        result = resp.json()

        if result.get("status") != 1:
            raise RuntimeError(result.get("request"))

        captcha_id = result["request"]
        start = time.time()

        while time.time() - start < timeout:
            time.sleep(5)
            resp = requests.get(f"{self.base}/res.php", params={
                "key": self.api_key,
                "action": "get",
                "id": captcha_id,
                "json": 1,
            }, timeout=15)
            data = resp.json()
            if data["request"] != "CAPCHA_NOT_READY":
                if data.get("status") == 1:
                    return data["request"]
                raise RuntimeError(data["request"])

        raise TimeoutError("Solve timeout")


# Run worker
if __name__ == "__main__":
    queue = CaptchaQueue()
    worker = QueueWorker(os.environ["CAPTCHAAI_KEY"], queue)
    worker.run()
用多进程启动一组 worker
单个 worker 等待 res.php 返回时基本空闲,所以并发数直接决定吞吐。下面用 multiprocessing 拉起 4 个进程:
import multiprocessing
import os


def start_workers(num_workers=4):
    """Launch multiple worker processes."""
    queue = CaptchaQueue()
    processes = []

    for i in range(num_workers):
        p = multiprocessing.Process(
            target=run_worker,
            args=(os.environ["CAPTCHAAI_KEY"],),
        )
        p.start()
        processes.append(p)
        print(f"Started worker {i + 1}/{num_workers}")

    return processes


def run_worker(api_key):
    queue = CaptchaQueue()
    worker = QueueWorker(api_key, queue)
    worker.run()


# Launch
processes = start_workers(num_workers=4)
生产环境更常见的是交给 systemd 或 Docker Compose 管理,进程挂了自动重启。
生产者示例:批量提交与等待结果
queue = CaptchaQueue()

# Submit tasks
urls = [
    "https://site1.com/login",
    "https://site2.com/register",
    "https://site3.com/checkout",
]

task_ids = []
for url in urls:
    tid = queue.submit("userrecaptcha", {
        "googlekey": "SITE_KEY",
        "pageurl": url,
    })
    task_ids.append(tid)
    print(f"Submitted {tid} for {url}")

# Wait for all results
for tid in task_ids:
    result = queue.wait_result(tid, timeout=120)
    status = result["status"] if result else "timeout"
    print(f"{tid}: {status}")

# Check queue stats
print(queue.queue_stats())
生产者不阻塞在识别上,只把 sitekey 和 pageurl 丢进队列、记下 task ID。真实业务里更推荐把 wait_result 换成下面的 Pub/Sub 监听。
Pub/Sub 结果监听:不用一直轮询
import threading


def listen_results(queue):
    """Listen for completed task notifications."""
    pubsub = queue.redis.pubsub()
    pubsub.subscribe(queue.notify_channel)

    for message in pubsub.listen():
        if message["type"] == "message":
            task_id = message["data"].decode()
            result = queue.get_result(task_id)
            print(f"Task {task_id} completed: {result['status']}")


# Run listener in background
listener = threading.Thread(
    target=listen_results,
    args=(CaptchaQueue(),),
    daemon=True,
)
listener.start()
pubsub.listen() 阻塞,所以放进守护线程。Pub/Sub 不做补发:监听端重启后先扫一遍结果 Hash 对账,再进监听循环。
worker 数量怎么定:对齐线程额度
开多少个 worker,不看 Redis 扛得住多少,而看账户能同时跑多少识别任务。CaptchaAI 按并发线程计费,套餐内识别次数不限:BASIC $15/月 5 线程、ADVANCE $90/月 50 线程、PREMIUM $170/月 100 线程,往上到 VIP-3 $7,500。原则是并发 worker 数 ≤ 套餐线程数,多出来的请求只是排队。
一个跨境电商团队的做法
某比价团队白天补抓海外站点,晚上跑全量。海外站点多用 reCAPTCHA v2 和 Turnstile,国内合作方站点则是 GeeTest(极验)——CaptchaAI 支持 GeeTest v3,v4 只是"即将支持",选型时要区分。他们用一个队列承载三类任务,method 区分 userrecaptcha、turnstile、geetest,夜间全量走默认优先级,白天补抓插队头,ADVANCE 的 50 线程配 40 个 worker。reCAPTCHA 依赖 Google 托管脚本,国内网络未必稳定加载,所以 worker 放在境外节点,本地只留生产者和 Redis。采集范围也要提前划清,只抓有授权的内容。
常见问题排查
| 现象 | 原因 | 处理方式 |
|---|---|---|
| 有任务但 worker 空闲 | 连到了别的 Redis 实例或库 | 核对 REDIS_URL 与 db 编号 |
| 结果查不到了 | 没做 TTL 管理或已被清理 | 用 setex 标记过期,及时取走结果 |
| 队列长度只涨不跌 | worker 或线程额度不够 | 加 worker 进程,或提升套餐线程数 |
| 同一任务被处理两次 | 任务已 pop,worker 崩溃 | 改用 brpoplpush 做可靠队列 |
| 大量任务超时 | 轮询窗口太短或网络抖动 | 放宽 timeout,失败任务指数退避重试 |
常见问题
worker 中途挂了,任务会丢吗?
用 blpop 会丢:任务已出队但结果没写回。不能丢就换 brpoplpush,先放进处理中列表,完成后再删除。
用 Redis Streams 会比 List 更好吗?
Streams 有消费者组和 ACK,worker 崩溃后任务能重新投递,生产环境更稳。List 胜在简单,适合先验证链路。
识别出来的 token 可以缓存复用吗?
不建议。token 有效期很短且通常与会话绑定,复用基本会被判为无效。结果 Hash 的 TTL 只是给对账排查用。
hCaptcha 和 GeeTest v4 能放进这个队列吗?
都不行。CaptchaAI 覆盖 reCAPTCHA v2/v3(含 Enterprise)、Cloudflare Turnstile 与 Challenge、GeeTest v3、图片/OCR、九宫格、BLS 等 12 种正式类型,另有 CaptchaFox(测试版)、Friendly Captcha(测试版)、Lemin(测试版)。GeeTest v4 官方口径是即将支持。
相关指南
把识别任务分发出去——开始使用 CaptchaAI。