判据只有一句:同一流程里的请求要不要彼此认得。要就用粘性会话,不要就用轮换会话。
原因在出口 IP:token 在哪个 IP 下识别出来,站点往往就比对哪个 IP。中途换 IP,token 大概率作废;反过来,独立请求钉在同一 IP 上也更快撞限流。
| 工作流 | 模式 | 原因 |
|---|---|---|
| 登录、注册、带验证码的表单 | 粘性 | token 绑定识别时的出口 IP |
| 结算、支付、多页跳转 | 粘性 | cookie 要跨请求延续 |
| 批量采集、搜索结果页 | 轮换 | 摊薄单 IP 密度 |
| 高频轮询、价格监控 | 轮换 | 请求彼此独立 |
下面两个数字来自内部观测样本,仅供参考:多步骤流程走轮换的触发率约 30–50%,改用粘性后约 5–10%,请在自有环境中测量。
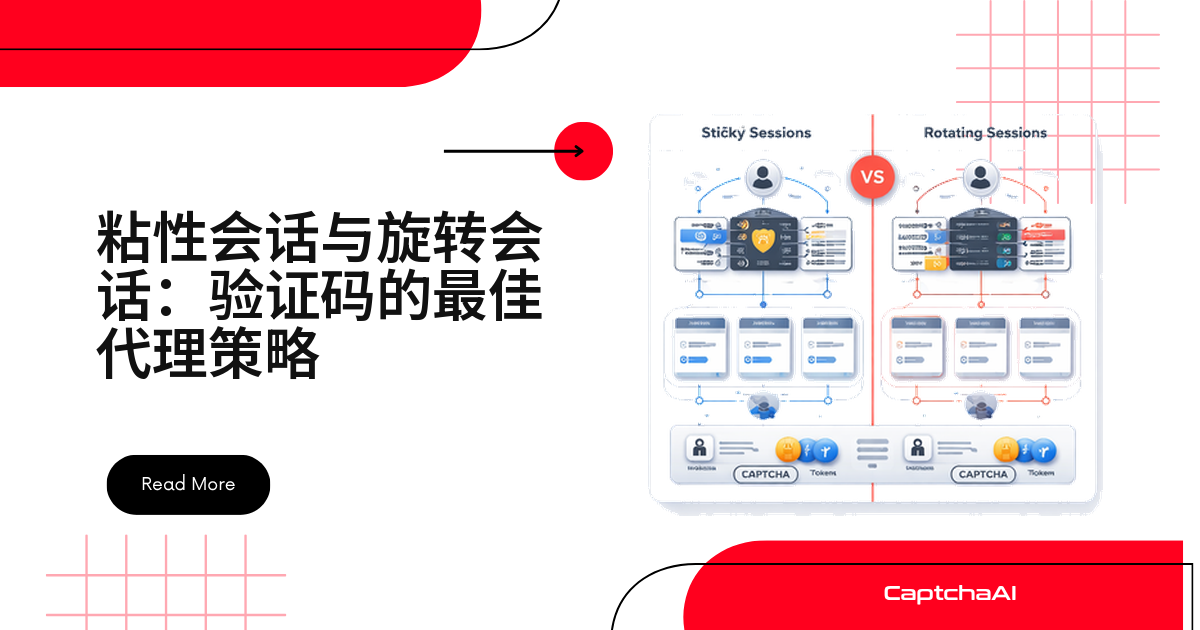
站点看到的两种模式
STICKY SESSION:
  Request 1 ──▶ IP: 192.168.1.50 ──▶ site.com/login
  Request 2 ──▶ IP: 192.168.1.50 ──▶ site.com/dashboard
  Request 3 ──▶ IP: 192.168.1.50 ──▶ site.com/account
  (Same IP for all requests in the session window)

ROTATING SESSION:
  Request 1 ──▶ IP: 192.168.1.50 ──▶ site.com/page1
  Request 2 ──▶ IP: 10.0.0.77   ──▶ site.com/page2
  Request 3 ──▶ IP: 172.16.5.22 ──▶ site.com/page3
  (Different IP per request)
粘性模式下是一个连续操作的访客,轮换模式下是一群陌生访客。
必须用粘性会话:登录、下单、带验证码的表单
一次登录至少三步:加载页面、识别验证码、带 token 提交,三步要走同一出口 IP。用 requests.Session 钉住最省事。
import requests
import time

CAPTCHAAI_KEY = "YOUR_API_KEY"
CAPTCHAAI_URL = "https://ocr.captchaai.com"

# Sticky session: same IP for the entire login flow
STICKY_PROXY = {
    "http": "http://user-session-abc123:[email protected]:5000",
    "https": "http://user-session-abc123:[email protected]:5000",
}

session = requests.Session()
session.proxies = STICKY_PROXY
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
    "AppleWebKit/537.36 Chrome/126.0.0.0 Safari/537.36",
})


def login_with_captcha(url, sitekey, username, password):
    """Full login flow — MUST use same IP throughout."""
    # Step 1: Load login page (IP: 192.168.1.50)
    session.get(url)

    # Step 2: Solve CAPTCHA (solved against IP: 192.168.1.50)
    token = solve_recaptcha(sitekey, url)

    # Step 3: Submit login (MUST be IP: 192.168.1.50)
    resp = session.post(url, data={
        "username": username,
        "password": password,
        "g-recaptcha-response": token,
    })

    return resp.status_code == 200


def solve_recaptcha(sitekey, pageurl):
    resp = requests.post(f"{CAPTCHAAI_URL}/in.php", data={
        "key": CAPTCHAAI_KEY,
        "method": "userrecaptcha",
        "googlekey": sitekey,
        "pageurl": pageurl,
        "json": 1,
    })
    task_id = resp.json()["request"]

    for _ in range(60):
        time.sleep(5)
        result = requests.get(f"{CAPTCHAAI_URL}/res.php", params={
            "key": CAPTCHAAI_KEY, "action": "get",
            "id": task_id, "json": 1,
        })
        data = result.json()
        if data["request"] != "CAPCHA_NOT_READY":
            return data["request"]

    raise TimeoutError("CAPTCHA solve timeout")
两个踩坑点:session.proxies 要在第一个请求前设好;字段名 g-recaptcha-response 不要改写,Turnstile 用 cf-turnstile-response。
token 被接受还是被拒,就差这一步
Sticky session:

  1. Browser loads page    → IP: 5.5.5.5
  2. CAPTCHA solved        → Token bound to session
  3. Form submitted        → IP: 5.5.5.5 ✅ Token accepted

Rotating session:

  1. Browser loads page    → IP: 5.5.5.5
  2. CAPTCHA solved        → Token bound to session
  3. Form submitted        → IP: 9.9.9.9 ❌ Token may be rejected
排查顺序固定下来:识别前和提交前各打印一次出口 IP,一致了再怀疑 pageurl 或 sitekey。
轮换会话更划算:批量采集与搜索结果页
请求之间不共享状态时,钉住 IP 只是负担。把请求摊到更大的 IP 池,单 IP 密度下降,触发概率随之降低。
import concurrent.futures

ROTATING_PROXY = {
    "http": "http://user:[email protected]:5000",
    "https": "http://user:[email protected]:5000",
}


def scrape_page(url):
    """Each request gets a fresh IP automatically."""
    resp = requests.get(
        url,
        proxies=ROTATING_PROXY,
        headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"},
        timeout=30,
    )
    if resp.status_code == 200:
        return url, resp.text
    return url, None


urls = [f"https://example.com/products?page={i}" for i in range(1, 501)]

with concurrent.futures.ThreadPoolExecutor(max_workers=10) as pool:
    results = list(pool.map(scrape_page, urls))
    success = sum(1 for _, html in results if html)
    print(f"Scraped: {success}/{len(urls)}")
搜索结果页对单 IP 查询量更敏感,几十次就可能撞上阈值:
def scrape_search(query, pages=10):
    results = []
    for page in range(pages):
        # Each request → new IP
        resp = requests.get(
            "https://search-engine.example.com/search",
            params={"q": query, "start": page * 10},
            proxies=ROTATING_PROXY,
            timeout=20,
        )
        results.append(resp.text)
        time.sleep(2)
    return results
time.sleep(2) 别删:换 IP 不等于能无限提速,请求间隔本身就是特征。
混合策略:登录走粘性,列表走轮换
真实项目很少只用一种模式,用一个管理类收口:
class HybridProxyManager:
    """Sticky for multi-step flows, rotating for single requests."""

    def __init__(self, provider_host, username, password, port=5000):
        self.host = provider_host
        self.username = username
        self.password = password
        self.port = port

    def get_rotating_proxy(self):
        return {
            "http": f"http://{self.username}:{self.password}@{self.host}:{self.port}",
            "https": f"http://{self.username}:{self.password}@{self.host}:{self.port}",
        }

    def get_sticky_proxy(self, session_id, duration_min=10):
        sticky_user = f"{self.username}-session-{session_id}-ttl-{duration_min}"
        return {
            "http": f"http://{sticky_user}:{self.password}@{self.host}:{self.port}",
            "https": f"http://{sticky_user}:{self.password}@{self.host}:{self.port}",
        }


proxy_mgr = HybridProxyManager("proxy.example.com", "user", "pass")


def scrape_with_auto_strategy(url, needs_login=False):
    if needs_login:
        # Multi-step → sticky
        import uuid
        session_id = uuid.uuid4().hex[:8]
        proxy = proxy_mgr.get_sticky_proxy(session_id)
    else:
        # Single page → rotating
        proxy = proxy_mgr.get_rotating_proxy()

    return requests.get(url, proxies=proxy, timeout=30)
session ID 取 uuid4() 前 8 位就够。服务商多把会话 ID 写进用户名,如 user-session-abc123,格式见 Bright Data 对接指南、Smartproxy 配置说明 和 Oxylabs 集成实践。
TTL 设多久:按流程 P95 耗时的两倍
| TTL | 适用场景 | 代价 |
|---|---|---|
| 1 分钟 | 单次快速表单 | 稍慢就中途过期 |
| 5 分钟 | 标准登录流程 | 平衡点,建议默认 |
| 10 分钟 | 多页面复杂流程 | 单 IP 请求累积 |
| 30 分钟以上 | 长时间连续浏览 | 特征明显,慎用 |
宁可略长也别卡上限,中途过期整个流程都要重来。服务商只是尽力维持同一 IP,代码里要留重新识别的退路。
Node.js 版本:同一份配置贯穿三步
逻辑与 Python 一致,改用 axios 的 proxy 配置项:
const axios = require("axios");

const CAPTCHAAI_KEY = "YOUR_API_KEY";
const PROXY_HOST = "proxy.example.com";
const PROXY_PORT = 5000;

function getProxy(mode, sessionId = null) {
  const user =
    mode === "sticky" ? `user-session-${sessionId}` : "user";

  return {
    proxy: {
      host: PROXY_HOST,
      port: PROXY_PORT,
      auth: { username: user, password: "pass" },
    },
  };
}

// Rotating: bulk scrape
async function scrapePages(urls) {
  const results = [];
  for (const url of urls) {
    const config = getProxy("rotating");
    const resp = await axios.get(url, { ...config, timeout: 30000 });
    results.push({ url, data: resp.data });
  }
  return results;
}

// Sticky: login flow
async function loginFlow(loginUrl, sitekey, credentials) {
  const sessionId = Date.now().toString(36);
  const config = getProxy("sticky", sessionId);

  // Step 1: Load page
  await axios.get(loginUrl, config);

  // Step 2: Solve CAPTCHA
  const submitResp = await axios.post(
    "https://ocr.captchaai.com/in.php",
    null,
    {
      params: {
        key: CAPTCHAAI_KEY,
        method: "userrecaptcha",
        googlekey: sitekey,
        pageurl: loginUrl,
        json: 1,
      },
    }
  );
  const taskId = submitResp.data.request;

  let token;
  for (let i = 0; i < 60; i++) {
    await new Promise((r) => setTimeout(r, 5000));
    const res = await axios.get("https://ocr.captchaai.com/res.php", {
      params: { key: CAPTCHAAI_KEY, action: "get", id: taskId, json: 1 },
    });
    if (res.data.request !== "CAPCHA_NOT_READY") {
      token = res.data.request;
      break;
    }
  }

  // Step 3: Submit with same IP
  return axios.post(
    loginUrl,
    {
      ...credentials,
      "g-recaptcha-response": token,
    },
    config
  );
}
关键在 loginFlow():同一份 config 既加载页面也提交表单。改做 Turnstile 时 method 换成 turnstile、字段换成 cf-turnstile-response。
国内项目要多算两件事
验证码类型不一样。 国内站点多用 GeeTest(极验)、网易易盾、腾讯防水墙,reCAPTCHA 多见于出海站。国内风控同样看重会话连续性,TTL 建议从 5 分钟起测,再按实测耗时上调。CaptchaAI 支持 GeeTest v3(v4 即将支持),不支持 hCaptcha 与 FunCaptcha(Arkose Labs),CaptchaFox、Friendly Captcha、Lemin 为测试版。
测量地点影响结论。 reCAPTCHA 依赖 Google 托管脚本,国内网络下耗时波动大,本地 P95 偏高,据此推出的 TTL 会虚高,基准测量放到境外 staging 更可信。采集范围限定在自有或已授权系统,遵循 robots 协议与《网络安全法》《数据安全法》、PIPL。
出问题时先查这张表
| 现象 | 根因 | 处理方式 |
|---|---|---|
| 识别成功但 token 被拒 | 中途换了出口 IP | 改用粘性,全程复用同一 session |
| 单页采集触发率飙升 | 同一 IP 访问页面过多 | 切回轮换或缩短 TTL |
| 轮换模式变慢 | 每次新 IP 重建连接 | 复用连接池,降低并发 |
CaptchaAI 按线程计费,不按次计费:BASIC($15/月,5 线程)到 VIP-3($7,500/月,5,000 线程),识别次数不限。选错模式不多付识别费,代价在吞吐——重试照样占线程。
常见问题
改成粘性会话后 token 还是被拒,怎么排查?
先确认三步是否真的走在同一条 session 上。常见错误是建了 requests.Session(),某一步却写成模块级 requests.get()。再核对 pageurl 与提交页是否一致。
怎么确认出口 IP 到底变没变?
在识别前和提交前各调一次自有的 echo 接口,把来源 IP 打进日志。两次不一致,问题就在会话模式;一致却仍被拒,再查 sitekey 和字段名。
Turnstile 的 token 也要求同一出口 IP 吗?
按同样的规则处理最省事。cf-turnstile-response 同样是一次性凭据,站点服务端可以连同请求上下文一起校验,严不严格取决于站点配置。
延伸阅读
会话模式和工作流对上号,是提升通过率最便宜的一步。领取 CaptchaAI API Key,两种模式各跑一轮。